
AI Tokenomics
AIエージェントの請求書が膨らむ前に:Big-T記法でトークン消費を設計する
AIワークロードのトークン消費が、利用量、モデル呼び出し、エージェント階層によってどう増えるかを分類するBig-T記法を解説する。
AIトークノミクスのうち、エージェントの呼び出し構造とトークン消費の増え方を扱います。 事業の採算まで測る場合は、AIトークノミクスの定義と成果単価の計算例を参照してください。
AIエージェントに「この資料を調べて、報告書を作って」と一度だけ依頼する。
画面上では一回の依頼です。 しかし、その裏ではモデルが計画を立て、検索し、Toolを呼び、結果を読み、必要ならやり直しています。 複数のサブエージェントへ仕事を分ければ、一回の依頼からモデル呼び出しの木が広がります。
利用者が見ている「一回」と、請求書に現れる仕事量は一致しません。
2026年6月、Dan Neff氏はTokenomics FoundationからWorking Draftとして公開した論文「Big-T Notation Paper: A Framework for Token Efficiency」で、この増え方を分類するBig-T記法を提案しました。
Big-Tが扱うのは、モデルを学習するコストではありません。 運用中のAIワークロードが、利用量、入力の大きさ、モデル呼び出し回数、エージェントの自律性によって、どのようにトークン消費を増やすかです。
Big-Tは正確な請求額を当てる式ではない
Big-Tの発想は、アルゴリズムの計算量を表すBig-O記法に似ています。
Big-Oは、ある処理に何ミリ秒かかるかを直接予測するものではありません。 入力が大きくなったとき、処理時間や必要なメモリがどのような曲線で増えるかを分類します。
Big-Tも、次の請求額を正確に計算するための式ではありません。 AIの利用が広がったとき、トークン消費がどのような構造で増えるかを、設計段階で共有するための言葉です。
論文も、この位置づけを明確にしています。
“Big-T is not a formal mathematical system. There are no proofs and no master theorem. It is a thinking tool.”
Big-Tは形式的な数学体系ではない。 証明もマスター定理もない。 思考の道具である。(筆者訳)
Big-Tの記号を、Big-Oと同じ厳密さを持つ漸近記法として読むと誤解します。
たとえば、後述する k と a が固定値なら、n に対する増え方は数学的には線形のままです。
Big-Tでは、厳密な証明よりも、利用量の増加に伴って何が増えるのかを設計者が見落とさないことを優先しています。
T(n・k・a)が表す三つの増幅要因
Big-Tは、AIワークロードのトークン消費を T(n・k・a) という形で捉えます。
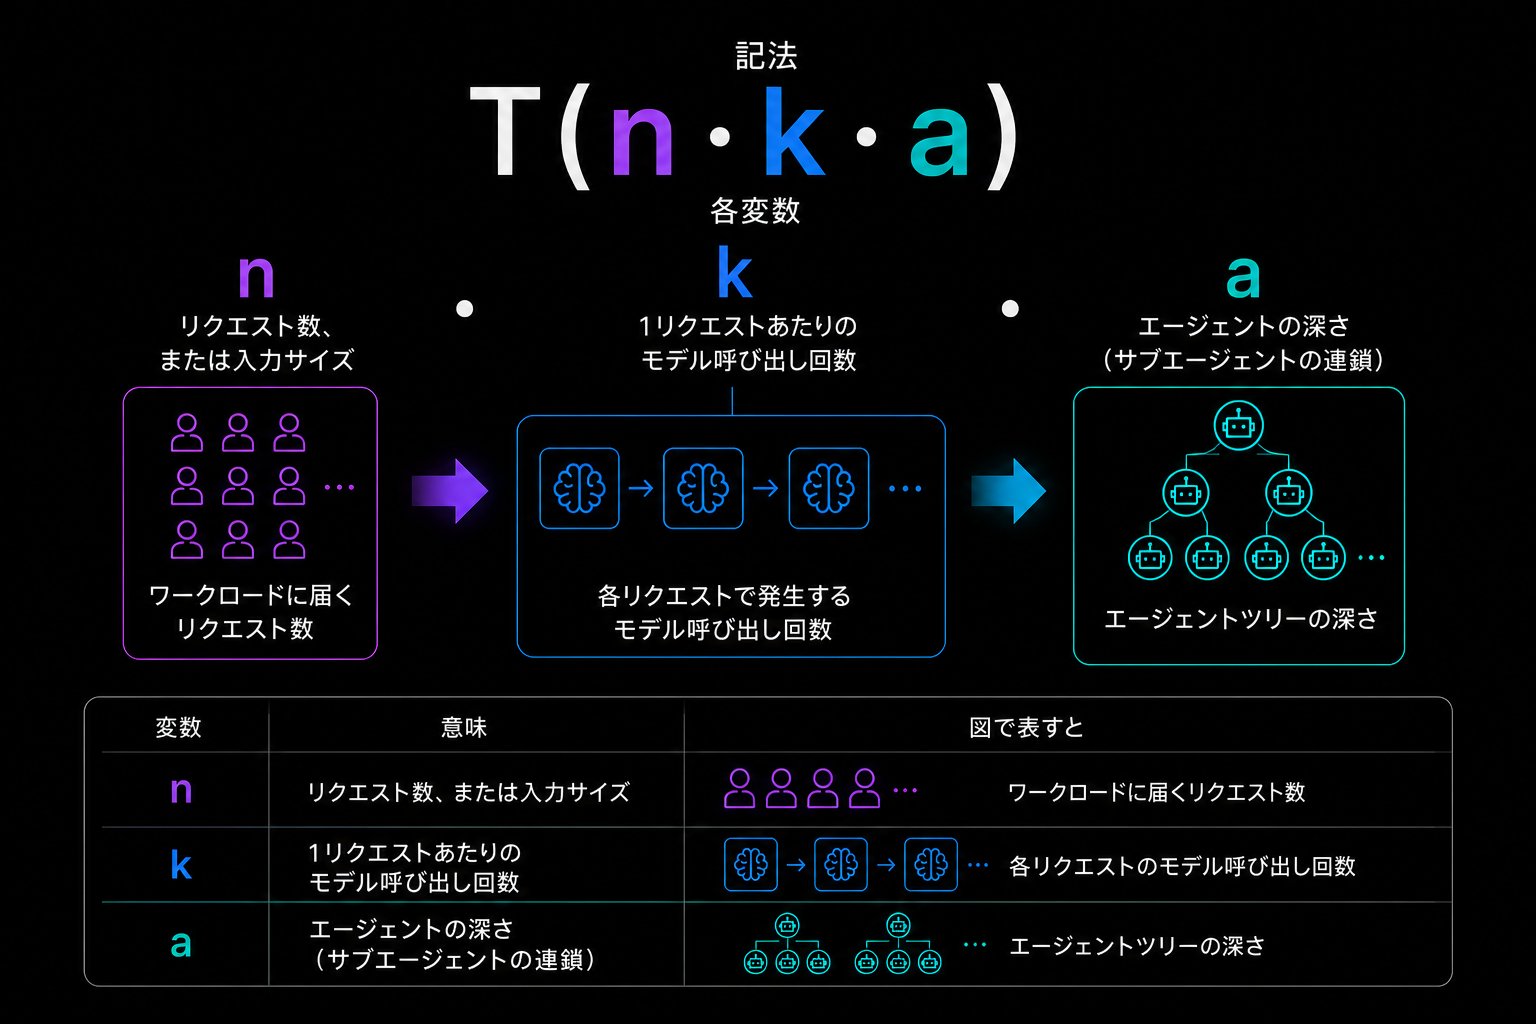
図1:Big-T記法を構成する三つの変数。原図をimagegenで日本語化して再制作。出典:Dan Neff「Big-T Notation Paper」、Tokenomics Foundation、CC BY 4.0。
- n:リクエスト数、または一回のリクエストに含まれる入力の大きさ
- k:一回のリクエストで発生するモデル呼び出しの回数
- a:サブエージェントが連なる深さ
n は意図的に緩く定義されています。
利用者が増えるサービスではリクエスト数が n になり、長い文書を読む処理では入力サイズが n になります。
したがって、Big-Tを使う前に「このワークロードでは何を n とするか」を決める必要があります。
リクエスト数と入力サイズを同時に追う場合は、二つの指標を分けて記録したほうが、実際のコスト要因を特定しやすくなります。
k には、推論の反復、Tool利用、結果の再評価、リトライが入ります。
利用者から見えにくいのは、この k です。
短い回答しか表示されなくても、その回答に至るまでにモデルが何度も呼ばれていれば、内部では多くのトークンを消費します。
a は、オーケストレーターがサブエージェントを呼び、そのサブエージェントが別の処理を呼ぶ階層を表します。
実運用では深さだけでなく、各階層でいくつに分岐したかも併記すると、エージェント全体の仕事量を把握しやすくなります。
Big-Tの6つのクラス
論文は、AIワークロードを6つのクラスに分類しています。
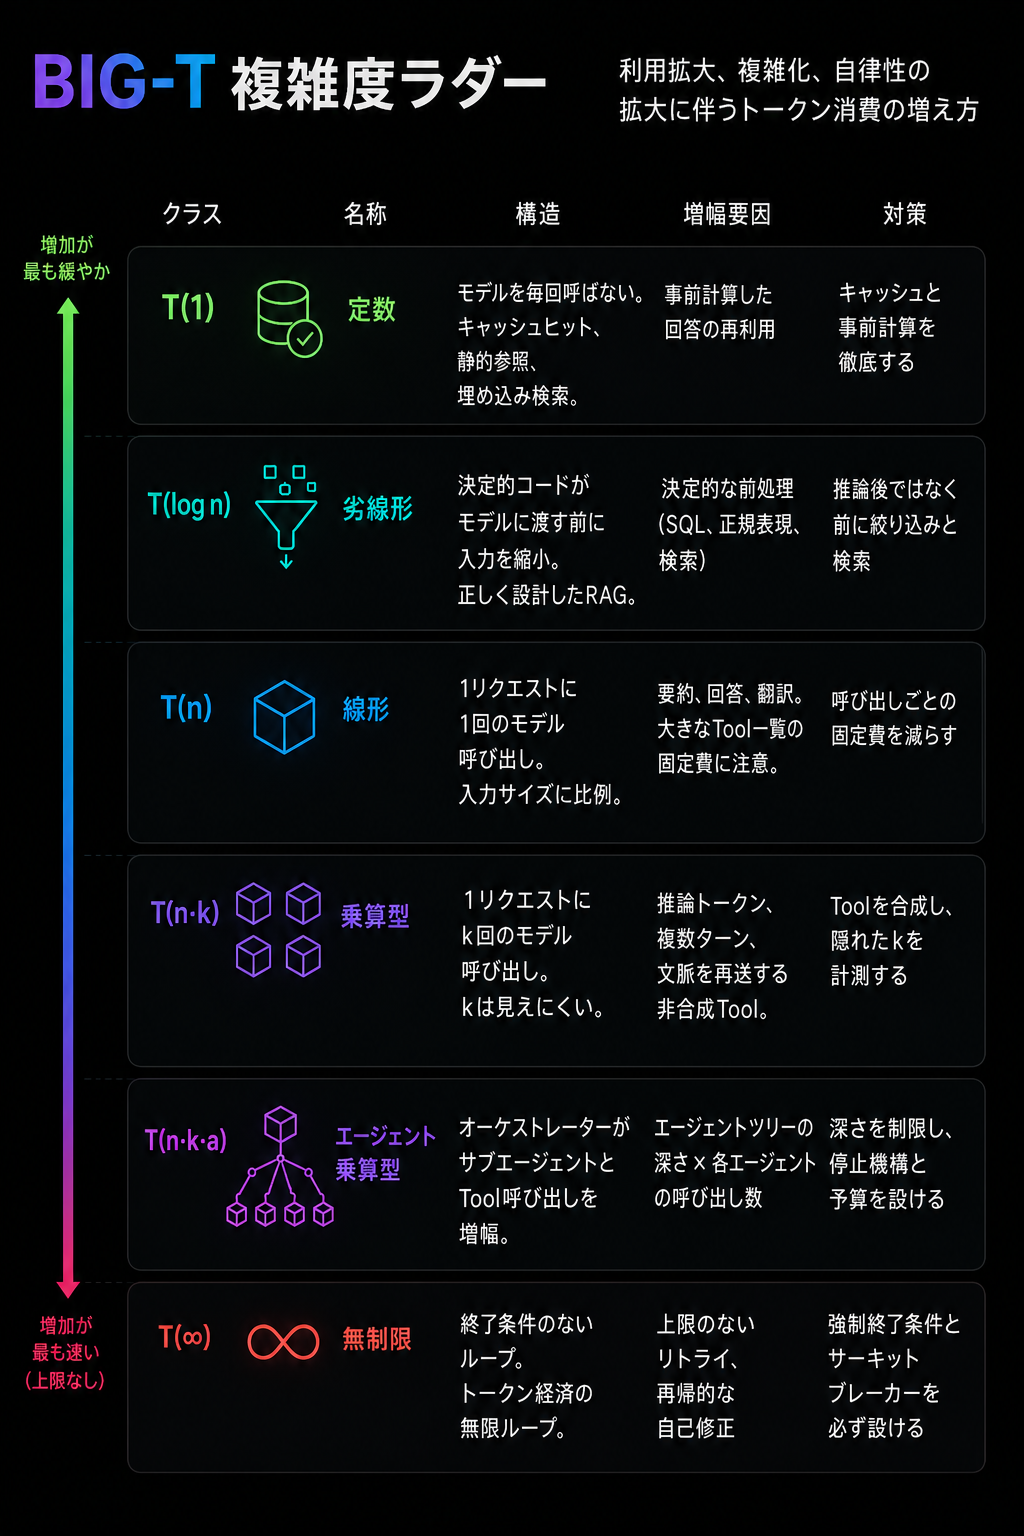
図2:トークン消費の増え方を示すBig-T複雑度ラダー。原図をimagegenで日本語化して再制作。出典:Dan Neff「Big-T Notation Paper」、Tokenomics Foundation、CC BY 4.0。
| クラス | トークン消費の構造 | 代表例 | 最初に検討する対策 |
|---|---|---|---|
T(1) |
リクエストごとにモデルを呼ばない | キャッシュ済み回答、静的な検索結果 | 再利用できる結果を事前計算する |
T(log n) |
モデルへ渡す前に入力を絞る | SQLによる抽出、検索、適切に設計したRAG | 決定的な処理で対象データを減らす |
T(n) |
リクエスト数や入力サイズに比例する | 一回の要約、翻訳、質問応答 | 毎回付与する文脈やTool定義を減らす |
T(n・k) |
一回の依頼でモデルを繰り返し呼ぶ | 複数段階のTool利用、推論ループ | Toolを合成し、文脈の再送を減らす |
T(n・k・a) |
呼び出しがエージェント階層へ広がる | オーケストレーターとサブエージェント群 | 深さ、分岐、予算、停止条件に上限を設ける |
T(∞) |
終了条件がなく、消費量に上限がない | 上限のないリトライ、再帰的な自己修正 | 強制終了とサーキットブレーカーを実装する |
この表は、下へ行くほど「悪い」というランキングではありません。 高い複雑度の処理でも、それに見合う事業価値があれば採用できます。
たとえば、複数のエージェントが調査と検証を分担することで、人では難しかった仕事を完了できるなら、T(n・k・a) は合理的です。
一方、毎日の定型報告を短く要約するだけの処理に、同じ構成を使う必要があるかは見直せます。
Big-Tが経営と開発に共通の問いを与えるのは、この場面です。 問題にするのはトークン消費の多さだけではなく、その増え方が得られる価値によって正当化されるかどうかです。
モデルを替えなくてもクラスは下げられる
論文には、Toolのインターフェースを変える例が紹介されています。
変更前のエージェントは30個のTool定義を毎回コンテキストへ読み込み、5段階の処理を一つずつ実行します。 Tool同士が結果を直接渡せないため、各段階でモデルへ戻り、増え続ける会話履歴と30個のTool定義を再送します。
この構成では、一回の依頼 n に対してモデル呼び出し k が掛かるため、T(n・k) になります。
変更後は、30個のToolを一つのインターフェースの背後にまとめ、5段階の処理を構造化された一つの命令として実行します。 モデルが読むTool定義は一つ、モデルとの往復も一回です。
論文によれば、仕事と出力を変えずにトークン消費を1桁のオーダーで減らし、クラスを T(n・k) から T(n) へ移せるとしています。
ここで効いたのは、より安いモデルでも、短い指示文でもありません。 Tool同士を合成できるようにしたインターフェース設計です。
バッチ処理をコードへ移す方法も、同じ考え方です。 31件の予定を登録するために31回モデルを呼ぶ代わりに、モデルが一度だけループ処理のコードを生成し、サンドボックス内で実行します。 外部システムへの操作回数は同じでも、反復を推論から通常の計算処理へ移せるため、トークン消費の増幅を抑えられます。
クラスの変更と単価の改善を分ける
Big-Tでは、コスト改善を二段階に分けます。
最初に、ワークロードがどのクラスに属するかを確認します。 キャッシュ、事前抽出、Toolの合成、反復処理のコード化など、アーキテクチャを変えることでクラス自体を下げられます。
次に、同じクラスの中で一回あたりのトークン量と単価を下げます。 論文は、そのための手段を五つ挙げています。
原文の図版は、実装時に操作する箇所を「不要な入力」「モデル選択」「複雑さ」「再利用」「出力」の五つに整理しています。
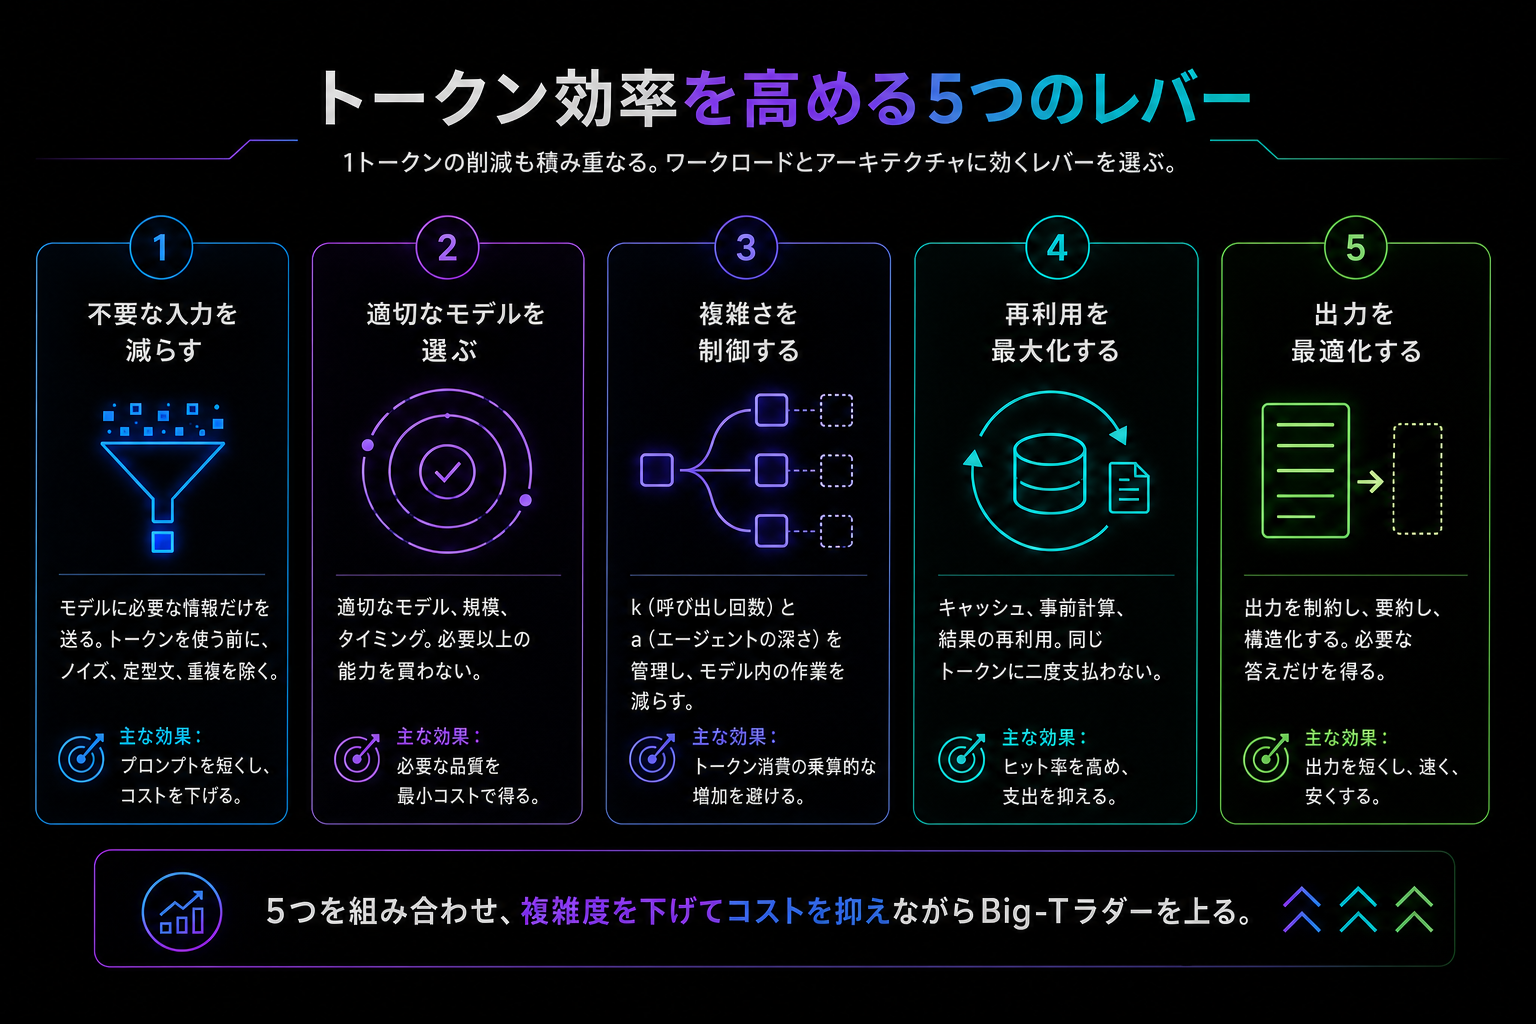
図3:トークン効率を高める五つの実装レバー。原図をimagegenで日本語化して再制作。出典:Dan Neff「Big-T Notation Paper」、Tokenomics Foundation、CC BY 4.0。
一方、論文本文の五つのレバーは、料金の透明性とガバナンスまで含む組織的な分類です。 図版と本文では粒度が異なるため、同じ五項目として混ぜずに読む必要があります。
- モデルルーティング:必要な品質を満たす範囲で、タスクごとに適切なモデルを選びます。
- プロンプトとシリアライズ:必要な情報だけを抽出し、同じ内容をより少ないトークンで表現します。
- キャッシュ:固定されたプロンプトの接頭辞や、繰り返し現れる質問への回答を再利用します。
- 料金の透明性:クレジット制や席単位の契約に隠れた、モデル呼び出しごとのトークン量と費用を見えるようにします。
- ワークロード分類とガバナンス:消費量の大きい処理が、事業上の価値が高い仕事につながっているかを確認します。
モデルルーティングや圧縮は、一回あたりの係数を小さくします。 それ自体に経済的な効果がありますが、反復回数やエージェント階層が増え続ける構造は変わりません。
単価を半分にしても、呼び出し回数が利用拡大とともに10倍、100倍になる設計なら、いずれ増幅のほうが勝ちます。 だからこそ、クラスの確認を先に行い、その後でクラス内の効率を改善します。
計測できなければBig-Tは使えない
Big-Tによる分類は、AIエージェントの内部を観測できることが前提です。
論文は、次の短い原則を置いています。
“Instrumentation comes before optimization.”
計測は最適化に先立つ。(筆者訳)
最低限、リクエストやタスクごとに次のデータを記録します。
- 入力トークン、出力トークン、推論トークン
- モデル呼び出し回数と、各呼び出しで再送したコンテキスト量
- Tool呼び出し、リトライ、キャッシュのヒット率
- サブエージェントの深さ、分岐数、停止理由
- モデル名、単価、処理時間、担当チーム、対象プロジェクト
この記録があれば、請求額が増えた理由を「利用者が増えた」「一回の依頼が重くなった」「内部の反復が増えた」「エージェントの分岐が増えた」に分けられます。
そのうえで、最も費用の大きいワークロードからクラスを付け、増幅要因が成果に必要かを確認します。 試験導入では許容できた構成も、全社展開すれば別の曲線を描くため、分類は一度で終わらせず、利用規模の変化に合わせて見直します。
Big-Tが扱わないボトルネック
トークン効率を改善しても、AIシステム全体がそのまま拡張できるとは限りません。
エージェントは、CRM、文書管理、チケット管理などの外部システムへ、人よりはるかに速い頻度でアクセスできます。 モデル呼び出しを減らしても、外部APIのレート制限、権限、同時実行数、ページネーションが次のボトルネックになることがあります。
論文は、この問題をBig-Tの最適化境界の外に置いています。 トークンの問題を解いた結果、制約が外部システムへ移っただけなら、ゲートウェイ設計、レート制限の調整、読み取り用の複製、エージェント専用アカウントなどを別に検討する必要があります。
Big-Tは、AIシステム全体の性能を一つの記号で説明するものではありません。 トークン消費という一つの制約を、設計と経営の共通言語にするための枠組みです。
AIの利用量ではなく、増え方を管理する
AIの利用を広げれば、総トークン量は増えます。 利用量を減らすことだけを目標にすると、高い価値を生むAI活用まで止めかねません。
Big-Tを使うと、議論の出発点が「トークンを使いすぎている」から変わります。
このワークロードでは、何を n としているのか。
一回の依頼の裏に、いくつの k が隠れているのか。
エージェント階層 a に上限はあるのか。
そして、その複雑度は得られる価値に見合っているのか。
請求書が届いてから使用量を削るのではなく、AIエージェントを設計する時点でこの四つを確認する。 Big-T記法は、そのための共通言語になります。
次の記事
トークン消費の増え方を分類した次は、1トークンの単価と消費量がどのレイヤーで決まるかを分けて確認します。
AIトークノミクス講座
AI支出の可視化、トークン効率、予算管理を実務へ組み込む方法を講座で解説します。
参考文献
- Dan Neff, “Big-T Notation Paper: A Framework for Token Efficiency,” Tokenomics Foundation, Working Draft, June 2026(2026年8月22日参照)。
この記事を書いた人
中村泰行(Yasu Nakamura)
株式会社麻布技術研究所 代表取締役社長。 サイバーセキュリティ、人工知能、セキュアシステム、事業成長を主な専門領域としています。